Tài nguyên GPU là mặt hàng khan hiếm trên toàn cầu do sự bùng nổ nhu cầu từ AI. Kể cả với hyperscaler như Google Cloud thì việc một khách hàng provision và scale được GPU ở quy mô nhất định cũng không phải luôn luôn dễ dàng. Google cung cấp một lựa chọn chip khác là TPU (Tensor Processing Unit), tuy nhiên sự khác biệt về kiến trúc phần cứng, framework phần mềm cũng như khả năng biên dịch vẫn luôn là một trở ngại khiến người dùng khó có thể thử nghiệm và triển khai sử dụng chúng trong các workload thực tế.
Tuy nhiên mới đây, ngày 20/10/2026, Google và đội PyTorch của Meta công bố open source TorchTPU, một backend cho phép code PyTorch chạy trực tiếp trên TPU. Điều này mở ra một lựa chọn hạ tầng mới hoàn toàn cho các doanh nghiệp trước đây đã quen làm việc với GPU cho bài toán inference.Team Data/AI của Cloud Ace đã thử nghiệm chạy một số mô hình gen media phổ biến hiện tại là FLUX (ảnh), Wan2.2 (video không tiếng) và MiniMax-H3 (video có tiếng) trên chip TPU v6e. Phần dưới đây ghi lại cách dựng, tốc độ đo được, và chi phí so với việc host cùng mô hình trên GPU và với các API sinh ảnh/video phổ biến.
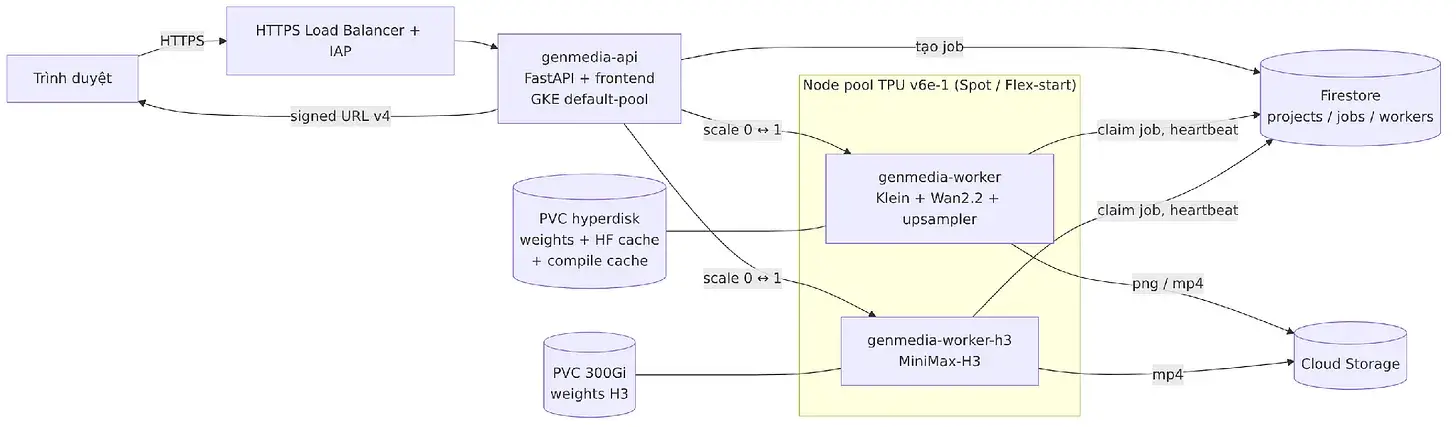
Team dựng hệ thống trên GKE với hàng đợi và worker TPU Spot: có request thì bật chip, rảnh thì tắt.
• Phần cứng: 1 chip TPU v6e (ct6e-standard-1t, 32 GiB HBM, 176 GiB RAM host) trên GKE, node pool Spot ở us-central1, tự scale được về 0.
• Phần mềm: image torch-tpu (torch 2.14, torch_tpu 0.2.0) cộng diffusers bản main. TorchTPU là điểm then chốt — code PyTorch/diffusers gần như giữ nguyên, chỉ đổi device=”tpu”, không phải viết lại bằng XLA thuần.
• Model thử nghiệm: FLUX 3 Image Klein và FLUX.1-schnell (ảnh), Wan2.2-TI2V-5B (video không tiếng), MiniMax-H3 33B (video có tiếng).
• Thành phần chính: API FastAPI trên node pool thường (không cần TPU); hàng đợi jobs trong Firestore (queued → running → done/failed), worker nhận job bằng compare-and-swap để không trùng; kết quả lưu Cloud Storage và tải qua signed URL; đĩa PVC giữ weights và compile cache TorchTPU (model lớn, cache theo shape nên cần đĩa bền).
• Worker: mỗi worker là một Deployment 1 replica trên 1 chip, strategy Recreate để không có hai pod tranh một chip. Worker chính giữ Klein và Wan2.2 trong RAM host, chỉ đưa model đang dùng lên HBM — đổi giữa ảnh và video mất khoảng 12–15 giây, không phải compile lại. Worker MiniMax-H3 chạy riêng vì weights lớn.
• Spot rẻ hơn on-demand nhưng node có thể bị thu hồi bất cứ lúc nào. Khi worker khởi động lại, các job đang chạy dở được đưa lại hàng đợi.
• Cold start worker chính khoảng 8–26 phút (cấp node + nạp model + warmup); H3 khoảng 10–25 phút. Compile cache lưu trên PVC nên lần sau dùng lại. Worker tự tắt sau 15 phút rảnh (H3: 30 phút) để thu hồi node.
Điểm cần chú ý khi cài đặt là giữ nguyên bản torch và torch_tpu:
FROM us-docker.pkg.dev/ml-oss-artifacts-published/torch-tpu-public-release-container/torch-tpu:latest
RUN pip freeze | grep -iE ‘^(torch|torch[_-]tpu|torchvision|torchax|jax|libtpu)’ > /tmp/pins.txt \
&& pip install --no-cache-dir -c /tmp/pins.txt -r requirements-worker.txt
Tiếp theo là quyết định thành phần nào đặt trên TPU:
# FLUX.1-schnell: text encoder ở CPU, chỉ transformer + VAE lên TPU
pipe.transformer.to(”tpu”); pipe.vae.to(”tpu”)
Một số điểm team Cloud Ace rút ra khi dựng:
🔹 Compile theo hình dạng tensor. Mỗi độ dài prompt, độ phân giải hay số frame là một lần compile (30–110 giây), nên cần cố định tập kích thước và warmup sẵn.
🔹 Chỉ đưa từng phần cần thiết lên TPU. Không chuyển cả pipeline lên TPU một lần bằng pipeline.to(”tpu”), vì phần text encoder đang chạy trên CPU sẽ bị kéo lên theo. Cũng không dùng from_pipe() để tạo pipeline mới, vì hàm này đổi model về định dạng số lớn hơn (float32). Với FLUX, dung lượng model khi đó tăng lên khoảng 44 GB, vượt quá bộ nhớ 32 GB của một chip.
Chúng tôi dựng một web app đơn giản trên Google Kubernetes Engine cho phép người dùng gõ prompt, hệ thống xếp request vào hàng đợi, rồi worker TPU v6e Spot sinh ảnh hoặc video.
Model chạy bằng PyTorch nguyên bản qua TorchTPU và thư viện diffusers. Tốc độ đo được trên một chip, khi máy đã khởi động xong:

MiniMax-H3 lớn hơn bộ nhớ 32 GB của một chip, nên text encoder chạy trên CPU và transformer được đẩy từ RAM lên chip từng phần mỗi bước (~20.8 giây/bước). Tất cả số trên đo ở chế độ eager, chưa tối ưu riêng cho TPU.

Text → ảnh với FLUX 3 Image Klein: 1024×1024, 4.8 giây.

Khung hình từ video 5.2 giây có tiếng sinh bằng MiniMax-H3, khoảng 19 phút (gồm ~2 phút xử lý văn bản trên CPU).
Chúng tôi so sánh ba lựa chọn:
🔹 Native (API managed): gọi model có sẵn và trả tiền theo từng ảnh, từng giây video. Ví dụ Veo, Imagen, Nano Banana trên Vertex AI, hoặc FLUX API của Black Forest Labs.
🔹 GPU tự host: chạy model mã nguồn mở trên GPU trong project của mình, tính phí theo giờ máy hoạt động. Ví dụ host L4, A100, H100 trên GKE.
🔹 TPU tự host: chạy cùng các model mở đó trên TPU v6e loại Spot, cũng tính phí theo giờ máy hoạt động.
Với tự host, chi phí mỗi đầu ra phụ thuộc vào việc TPU bận bao nhiêu phần thời gian bị tính tiền:

Một ảnh gen bằng Klein tốn $0.0008 tiền TPU khi máy chạy liên tục, so với $0.009 khi gọi Klein qua API của Black Forest Labs. Lưu ý: Đường xanh đậm là tiền máy cộng khoản cố định (disk, storage, load balancer,...) $38/tháng.

MiniMax-H3 tự host tốn $0.193 tiền máy mỗi clip khi máy chạy liên tục, so với $0.40 qua API H3 768P, $0.20 với H3-Lite 768P và $0.25 với Veo 3.1 Lite. Chú ý là có khác biệt về độ phân giải: H3 tự host chạy 960×544 (544p) để vừa một chip.
🔹 TPU có thể host được các model gen media mới nhất hiện hành, với chi phí đầu ra thấp.
🔹 Google đã công bố thế hệ TPU 8t/8i (4/2026), dự kiến GA vào cuối năm, bổ sung thêm lựa chọn và nguồn cung cho người dùng.
🔹 TPU sẽ không thực sự thay thế, nhưng khách hàng có thể coi đây là một lựa chọn song song để chia bớt các workload của mình.
Cloud Ace - Managed Service Partner của Google Cloud